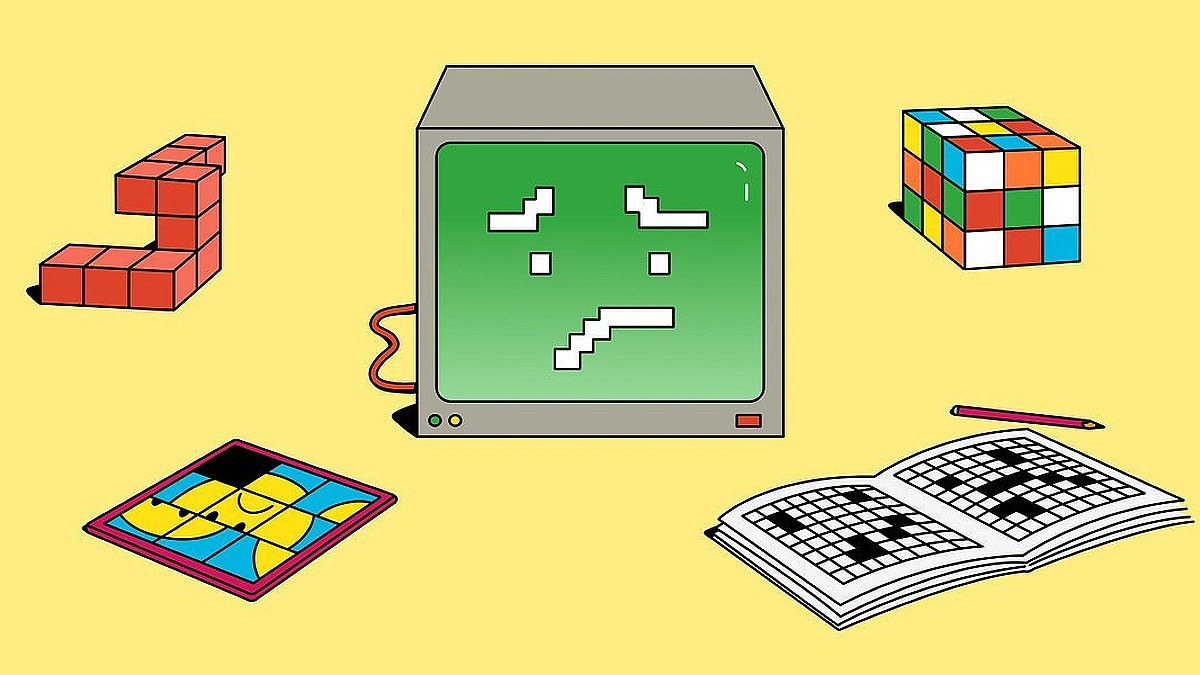
인공지능 모델이 고도의 지능 테스트나 논리 퍼즐에서 여전히 헛발질을 하는 현상이 포착됐다.
컴퓨터 과학의 역사 초기부터 퍼즐과 게임은 기계의 연산 능력과 발전 단계를 측정하는 핵심 수단이었다.
과거 IBM의 과학자 아서 사무엘이 머신러닝 개념을 대중화한 이래로, 수많은 알고리즘이 인간과의 두뇌 싸움에서 실력을 겨뤄왔다.
그렇다면 눈부시게 발전한 최신 인공지능은 왜 여전히 간단한 논리 문제나 게임에서 치명적인 실수를 반복하는 걸까?
기계 학습의 역사와 퍼즐 테스트의 의미
인공지능 개발자들은 기계가 얼마나 똑똑해졌는지 증명하기 위해 다양한 게임과 퍼즐을 테스트 도구로 활용한다.
단순한 연산을 넘어 고차원의 전략이 필요한 게임은 알고리즘의 한계를 명확히 보여주는 훌륭한 잣대이기 때문이다.
초기 컴퓨터 과학부터 이어져 온 이 전통은 오늘날 거대 언어 모델의 추론 능력을 검증하는 과정에서도 고스란히 재현되고 있다.
하지만 방대한 데이터를 학습한 최첨단 인공지능 모델조차 정교한 논리 퍼즐 앞에서는 엉뚱한 오답을 내놓곤 한다.
최신 인공지능이 논리 퍼즐에서 실패하는 이유
사람들은 대단한 연산 속도를 자랑하는 AI가 당연히 퍼즐도 기가 막히게 풀 것이라 기대한다.
그러나 실제 성능을 테스트해 보면 기본적인 규칙 유추나 단계별 논리 전개에서 허점을 드러내는 경우가 많다.
이러한 현상이 발생하는 결정적인 원인은 기계가 진짜 사고를 하는 것이 아니라 확률에 기반해 단어를 예측하기 때문이다.
결국 깊이 있는 논리적 사고나 문제 해결 능력이 요구되는 영역에서는 여전히 인간의 직관을 따라가지 못하는 한계가 존재한다.
인간과 인공지능의 지능 대결, 어디까지 왔을까
인간은 고차원의 규칙을 스스로 깨치고 전혀 새로운 상황에 유연하게 대처하는 능력을 갖추고 있다.
반면 머신러닝 시스템은 방대한 데이터 속에서 패턴을 찾아내는 데 특화되어 있어 예상 밖의 변수에는 무너진다.
이러한 차이점 때문에 전문가들은 AI의 발전 속도가 경이로움에도 불구하고 진정한 의미의 범용 지능에는 아직 갈 길이 멀다고 진단한다.
앞으로 개발자들이 이러한 논리적 공백을 어떻게 메워나갈지 귀추가 주목되는 시점이다.
자주 묻는 질문 (Q&A)
Q. 인공지능은 왜 복잡한 논리 퍼즐을 풀지 못하나요?
A. 진정한 의미의 사고를 하는 것이 아니라 방대한 데이터의 확률적 패턴을 조합하기 때문에 논리적 비약이나 실수가 발생합니다.
Q. 퍼즐 테스트가 AI 발전에서 차지하는 비중은 어느 정도인가요?
A. 알고리즘의 추론 능력과 한계를 객관적으로 검증할 수 있는 가장 원초적이면서도 확실한 척도로 평가받고 있습니다.
Q. 앞으로 AI의 논리적 사고 능력이 인간을 추월할 수 있을까요?
A. 현재의 학습 방식만으로는 한계가 있어 새로운 아키텍처나 접근법이 도입되어야 한다는 의견이 지배적입니다.
마치며
인공지능이 아무리 화려한 언어 구사력을 보여준다고 해도 기초적인 논리 퍼즐에서 흔들리는 모습은 시사하는 바가 크다.
기술의 발전 속도에 감탄하기보다 기계의 본질적인 한계를 정확히 이해하는 것이 앞으로의 시대를 대비하는 현명한 자세인 듯하다.
